Vengineerの妄想

公開情報の断片から、AI半導体の実装と次の一手を妄想します。

OpenROADの有償サポートを調べたら、Siemensにつながった

はじめに

OpenROADについて調べていると、ちょっと気になることがありました。

OpenROADはオープンソースのEDAで、RTLからGDSIIまでを対象としたチップ設計フローを構築しています。商用EDAではライセンス費用が大きな問題になりますが、OpenROADは「チップ設計のコストや参入障壁を下げる」ことを大きな目的にしています。

では、企業がOpenROADを本格的に使う場合、困ったときには誰に相談するのでしょうか?

オープンソースだから、全部自分たちで対応するのでしょうか。

調べてみたところ、OpenROADには有償の商用サポートを提供している会社がありました。

それが、Precision Innovations Inc.、略してPIIです。

そして、さらに調べてみると、2026年7月にSiemensがPrecision Innovationsを買収すると発表していました。

「OpenROADの商用サポート会社」として見つけた会社が、実はSiemensのEDA事業に入ろうとしている。

これは、OpenROADを考える上で気になる話です。

OpenROADを有償サポートするPrecision Innovations

OpenROADの公式サイトには「Professional Support」という項目があり、そこにPrecision Innovationsが掲載されています。

しかも、単にOpenROADを使っている会社として紹介されているわけではありません。

OpenROAD公式では、Precision InnovationsをOpenROADのprimary industrial developerと位置付け、企業向けにCommercial support、Custom tool development、Flow optimization、Enterprise-grade solutionsなどを提供すると説明しています。

つまり、

「OpenROADはオープンソースだから無料で使える」

という話と、

「企業がOpenROADを使って製品開発するための商用サポートがある」

という話は、両立しているわけです。

OpenROAD Ecosystem

なぜOpenROADに有償サポートが必要なのか

ここは、オープンソースEDAを考える上で重要なところだと思います。

RTL-to-GDSIIのフローを動かすだけなら、OpenROADをダウンロードして自分で環境を構築することもできます。

しかし、実際の半導体開発では、それだけでは終わりません。

PDKへの対応、フローのカスタマイズ、配置配線の問題、タイミングやPPAの改善、ツールのバグ修正、特定の設計条件への最適化など、設計ごとにさまざまな問題が出てきます。

そこで、OpenROADそのものを開発している専門家からサポートを受けられることには意味があります。

実際、OpenROADの2024年活動報告では、DARPAによるOpenROADへの資金提供が2023年12月31日に終了した後も開発を継続し、Precision Innovationsがpaid-support modelsを提供してOpenROADとユーザーの長期的な持続性を支えていると説明されています。

OpenROAD in 2024

これは、「オープンソース=商売にならない」という単純な話ではありません。

ソフトウェアそのものはオープンでも、その上に専門的なサポート、カスタマイズ、最適化というビジネスを成立させることができます。

実際に企業が使っている

では、実際にPIIのサポートを受けてOpenROADを使っている企業はあるのでしょうか?

ここで出てくるのが、プロセッサ開発を行っているAsceniumです。

OpenROAD公式の記事によると、Precision InnovationsはAsceniumに対して、OpenROADとASAP7 PDKを利用した設計見積もりについてdedicated supportを提供していました。

AsceniumがOpenROADを使った理由は、単に「安いEDAだから」というものではありません。

OpenROADを利用して、プロセッサのアーキテクチャを早い段階から探索することが目的でした。

さらに2026年2月に公開されたAsceniumの記事では、Design Space Exploration(DSE)を、設計の最後に行うPPAチューニングではなく、アーキテクチャ上の判断を検証するための中心的な手段として説明しています。

DSE using OpenROAD: A strategic advantage

そしてSiemensがPrecision Innovationsを買収へ

ここで話が大きく変わってきます。

2026年7月20日、SiemensはPrecision Innovationsを買収する契約を締結したと発表しました。

Siemensによれば、Precision InnovationsはオープンソースのOpenROAD frameworkをベースにEDAソフトウェアを開発している会社です。

その技術によって、SoCの設計サイクルの早い段階で、アーキテクチャや設計上のトレードオフを評価し、PPAを最適化することを狙っています。

Siemensは、Precision Innovationsの技術を自社のDigital Design Creationソフトウェアに組み込み、アーキテクチャ、実装、SoCのライフサイクル管理までをつなぐ方向を示しています。

Siemens、Precision Innovations買収発表

なお、2026年9月現在では買収契約の発表段階であり、取引完了は2026年第3四半期の予定とされています。

おわりに

今回、最初は単純に「OpenROADを有償でサポートしている会社はあるのだろうか?」と思って調べてみました。

すると、OpenROAD公式にはPrecision InnovationsがProfessional Supportの提供企業として明確に掲載されていました。

さらに、Asceniumというプロセッサ開発会社が、Precision Innovationsのサポートを受けながらOpenROADをDSEに利用していることも分かりました。

そして2026年7月、SiemensがPrecision Innovationsを買収すると発表しました。

こうして並べてみると、

OpenROAD ↓ Precision Innovationsによる有償サポート ↓ Asceniumによる利用 ↓ SiemensによるPrecision Innovations買収

という流れが見えてきます。

オープンソースのEDAプロジェクトを中心に、商用サポートを行う企業が生まれ、その技術を利用する半導体企業があり、さらにその会社を大手EDA企業であるSiemensが買収する。

では、Precision Innovationsは実際にどのような企業を顧客としてきたのでしょうか?

そして、AsceniumはOpenROADを使って、具体的にどのような設計を行っているのでしょうか?

このあたりを、もう少し掘ってみたいと思います。

この形なら、記事のテーマが「OpenROADの商用サポートエコシステム」に集中します。
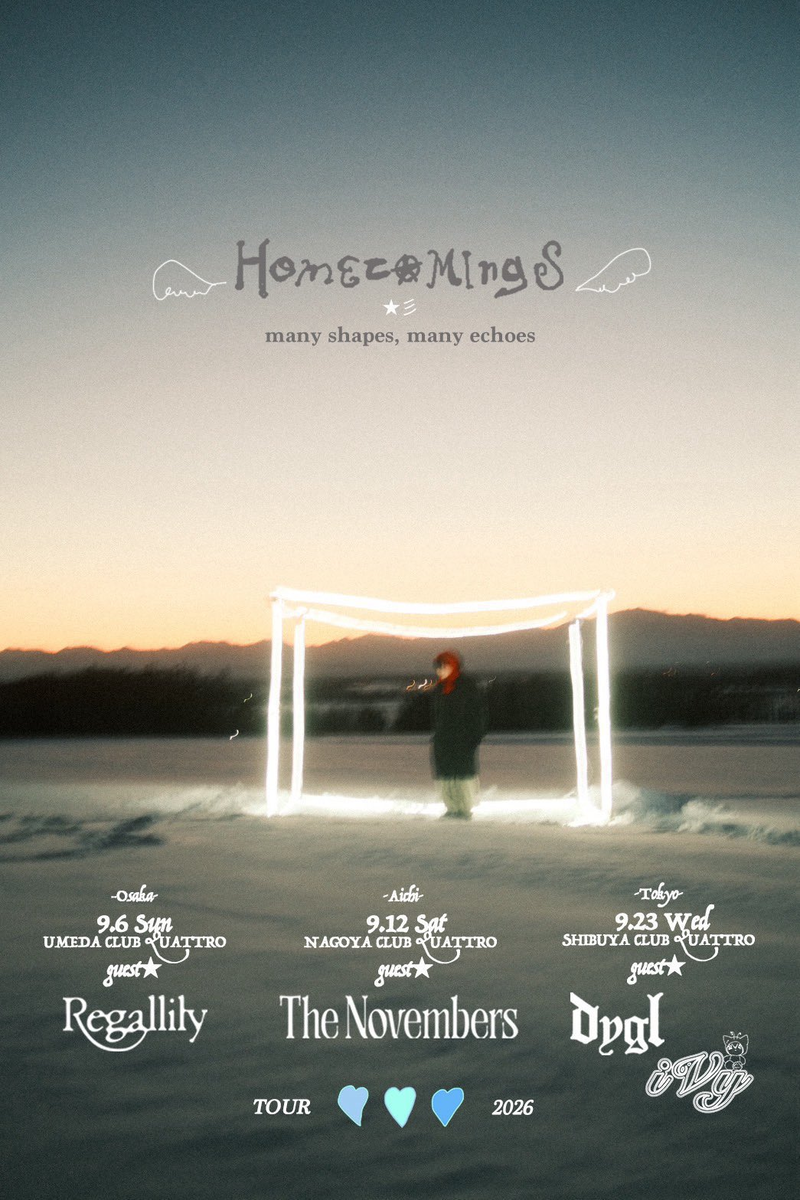
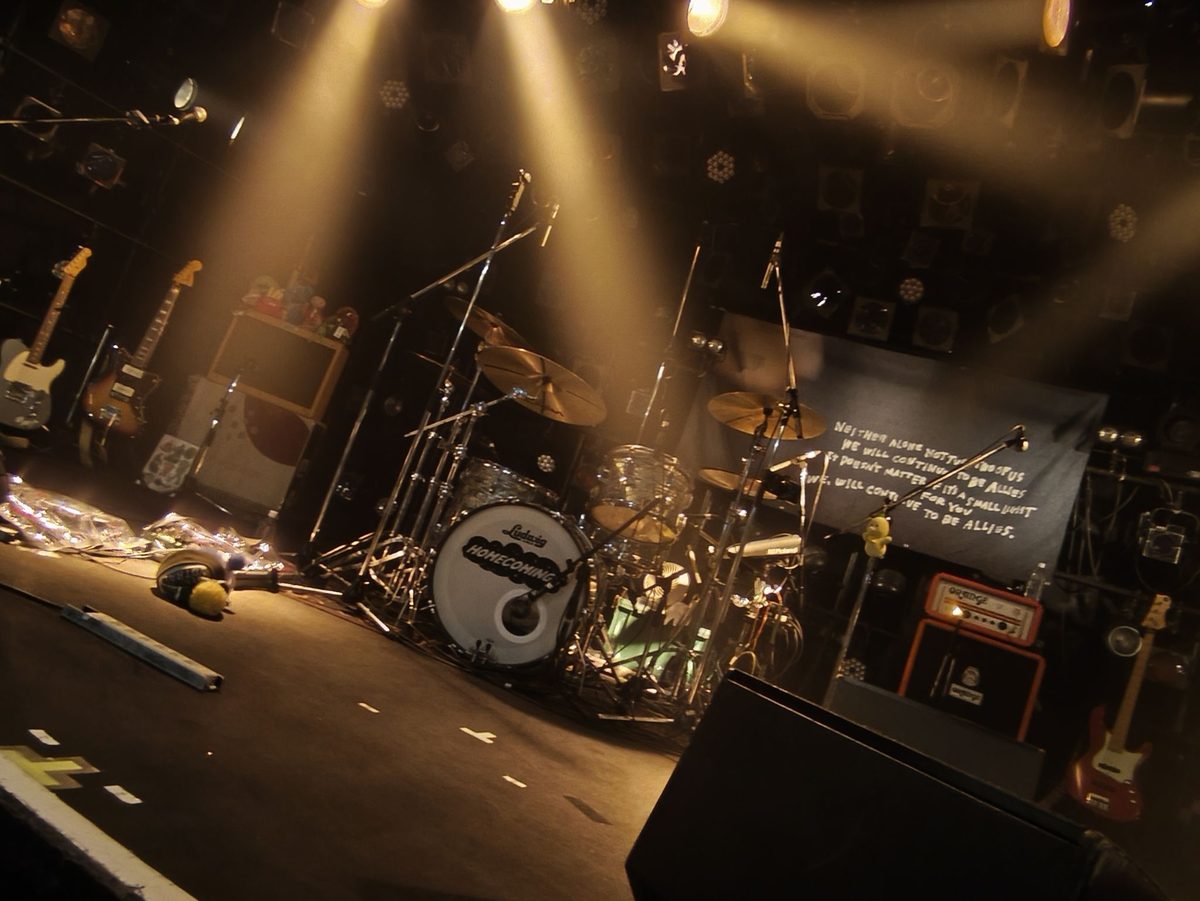
音楽 : Homecomings の対バンライブだったけど、予習でDYGLを聴きまくった結果

はじめに

今年、5回目のライブは、

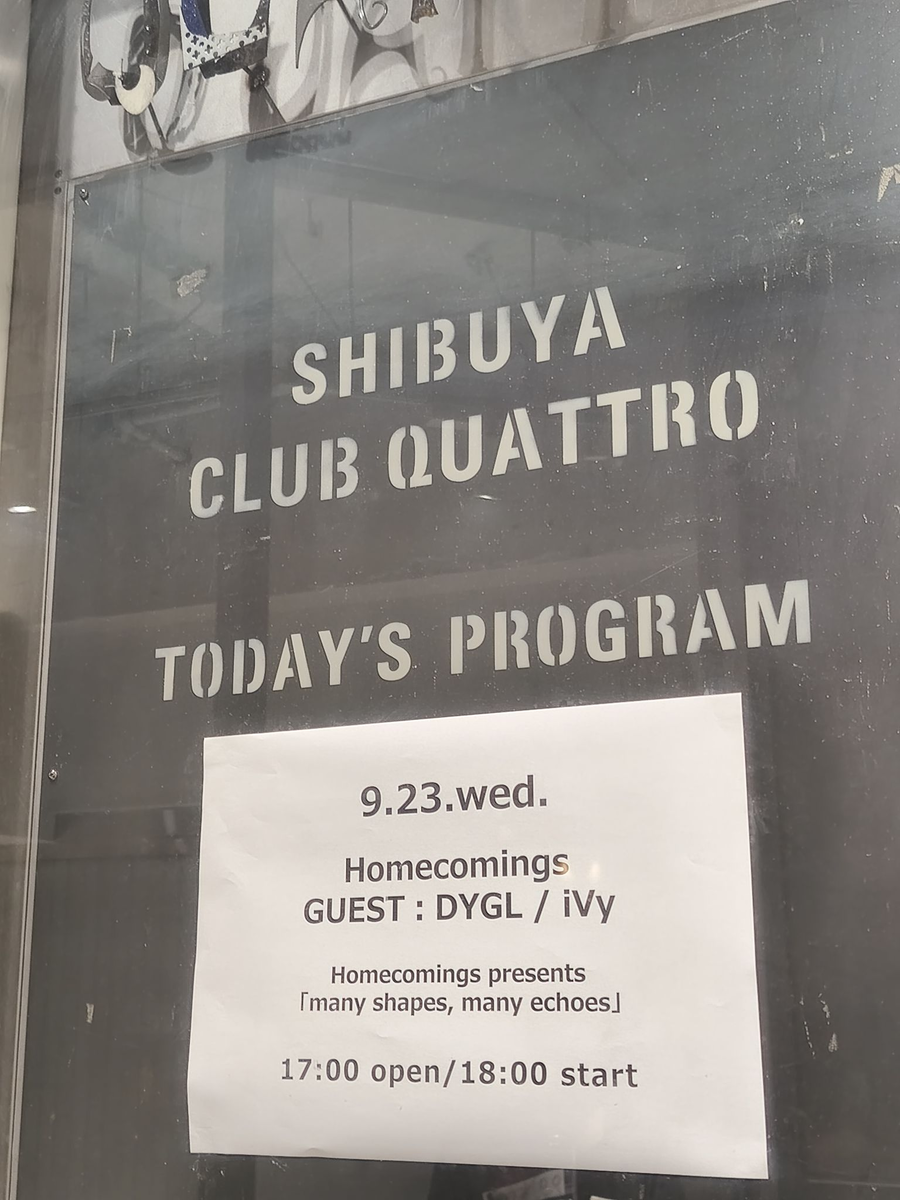
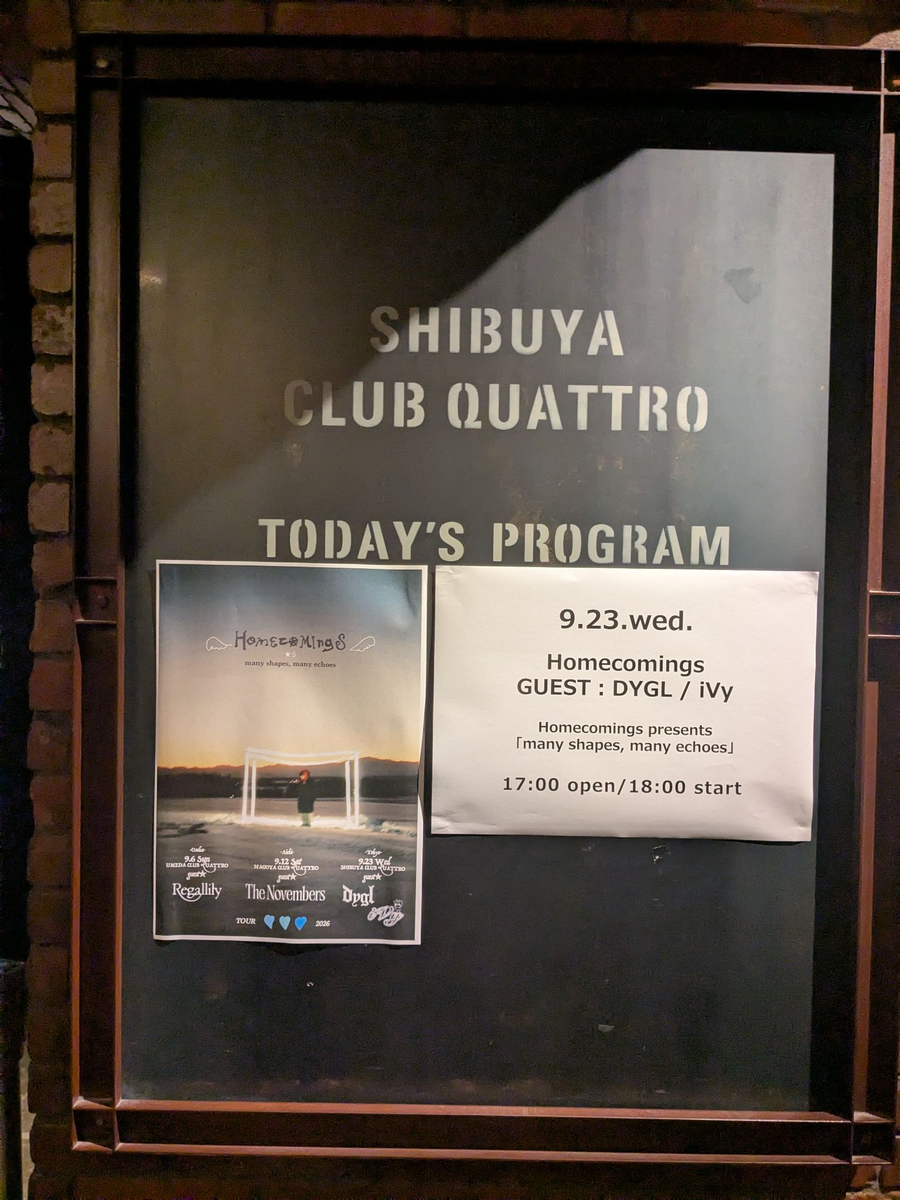
9月23日(水)、渋谷CLUB QUATTROにて、

  • Homecomings
  • DYGL
  • iVy

3組となると、DYGLとiVyの持ち時間は 20-30分なのか。。。。

羊文学 => リーガルリリー からの Homecoming

となって、たまたま見つけたライブに申し込みました。

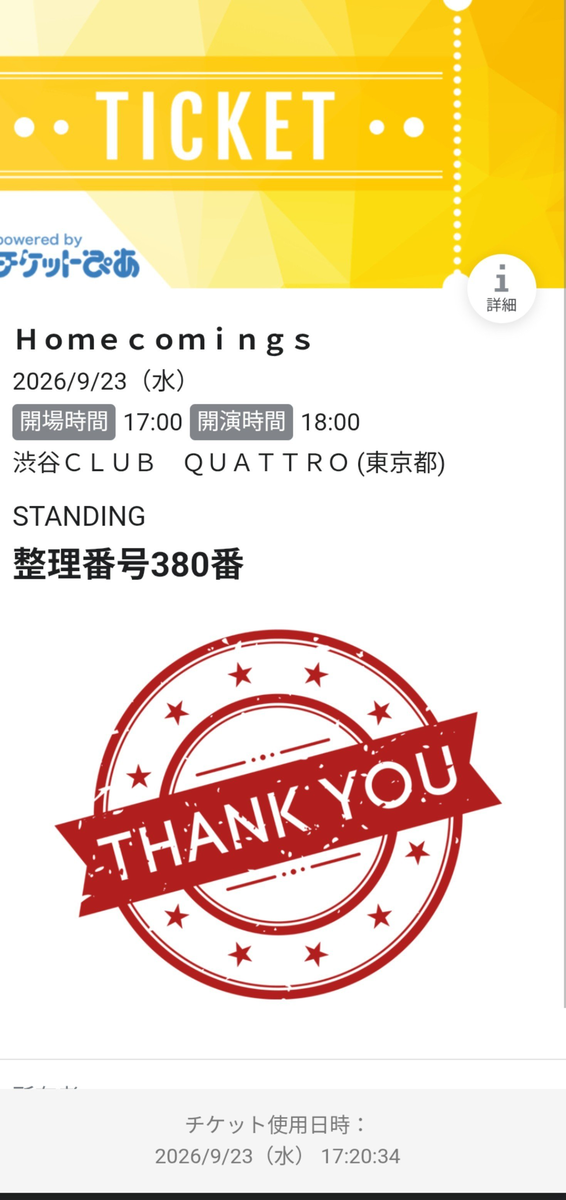
今回は、ぴあ、で申し込んだんですが、なんだかんだで、手数料が1000円も超えているんですよ。チケット代が6000円なのに。。。

整理番号は、380番なので、まー。chilldspot の時は400番を超えていましたが、平日だったのですが、今回は祝日です。

ということで、今回は、参加したモードでの参戦です。。。

DYGL

DYGL を予習できいたんですが、なんか、懐かしい感じがしました。Gemini -san に聞いたら、

DYGLの楽曲って、1970年代のBritish Rockに感じるんだけど、どうなの?

直感的にそう感じられるの、とてもよく分かります。ただ結論から言うと、DYGLが直接的な ルーツとして公言しているのは2000年代のインディー・ロック(The Strokes, Arctic Monkeysなど)や1980〜90年代のUK/USオルタナティヴが中心です。

それでも1970年代のBritish Rock(Glam Rock, Pub Rock, Early Punkなど)を感じさせるのには、音楽的にしっかりとした理由があります。

70年代British Rockを感じる理由

  • 骨太なギター・リフとコード進行 彼らの楽曲(特に1st『Say Goodbye to Memory Den』など)には、70年代のThe ClashやThe Jamといった初期パンク/パブロック特有の、シンプルで力強い歪みギターとグルーヴ感があります。
  • 生のアンサンブル感とダイナミクス 近年の作品(『Thirst』や『Thoresby』など)では、あえて完璧に整えすぎず、1発録りやアナログライクな質感、空間の鳴りを生かしたサウンドメイキングを行っています。これが70年代のスタジオ・レコーディングが持っていた特有の「生々しさ」や「ロックの衝動」とリンクします。
  • メロディの持つUK特有の哀愁 全編英語詞でありながら、メロディラインにはUKインディー特有の少し陰のあるポップネスや哀愁が宿っており、これが70年代ブリティッシュ・ロックの系譜を感じさせる要素になっています。

ルーツの系譜として見ると

DYGLが強い影響を受けた2000年代のガレージロック・リバイバル(The StrokesやThe Libertinesなど)自体が、1970年代のパブロックや初期パンク、ニューヨーク・パンクを再解釈して作られたムーブメントでした。

そのため、彼らの音を聴いたときに「2000年代インディー」を経由して、その奥にある70年代ブリティッシュ・ロックの遺伝子を自然と聴き取られているのだと言えます。

ちなみに、アルバムごとに70年代サイケ調の展開を取り入れたり(2nd『Songs of Innocence & Experience』)、90年代グランジ/オルタナへ傾倒したりと変化しているので、期によって聴こえ方が変わるのも面白いところです。

という回答を貰って、あー、あたしはお爺ちゃんの存在なのね。と感じました。

当日

3バンドなので、開場時間が1時間早い 17時、15分ぐらい前に着いたのでぶらぶらし、17時に1Fの階段で待機。

渋谷クラブクアトロ、1F の案内。

整理番号380番なので、かなり時間がかかりました。

4Fの受付前

受付の左側

会場に入ったら、8列ぐらいまでは並んでいました。今回は、3バンドで3時間半は立ちっぱなしなので、とりあえず、フロアの一番後ろの柵のところで寄りかかれるようにしました。

ここで、17時30分。30分の待ちです。

iVy

18時をちょっと過ぎで、iVyのオープンでスター。

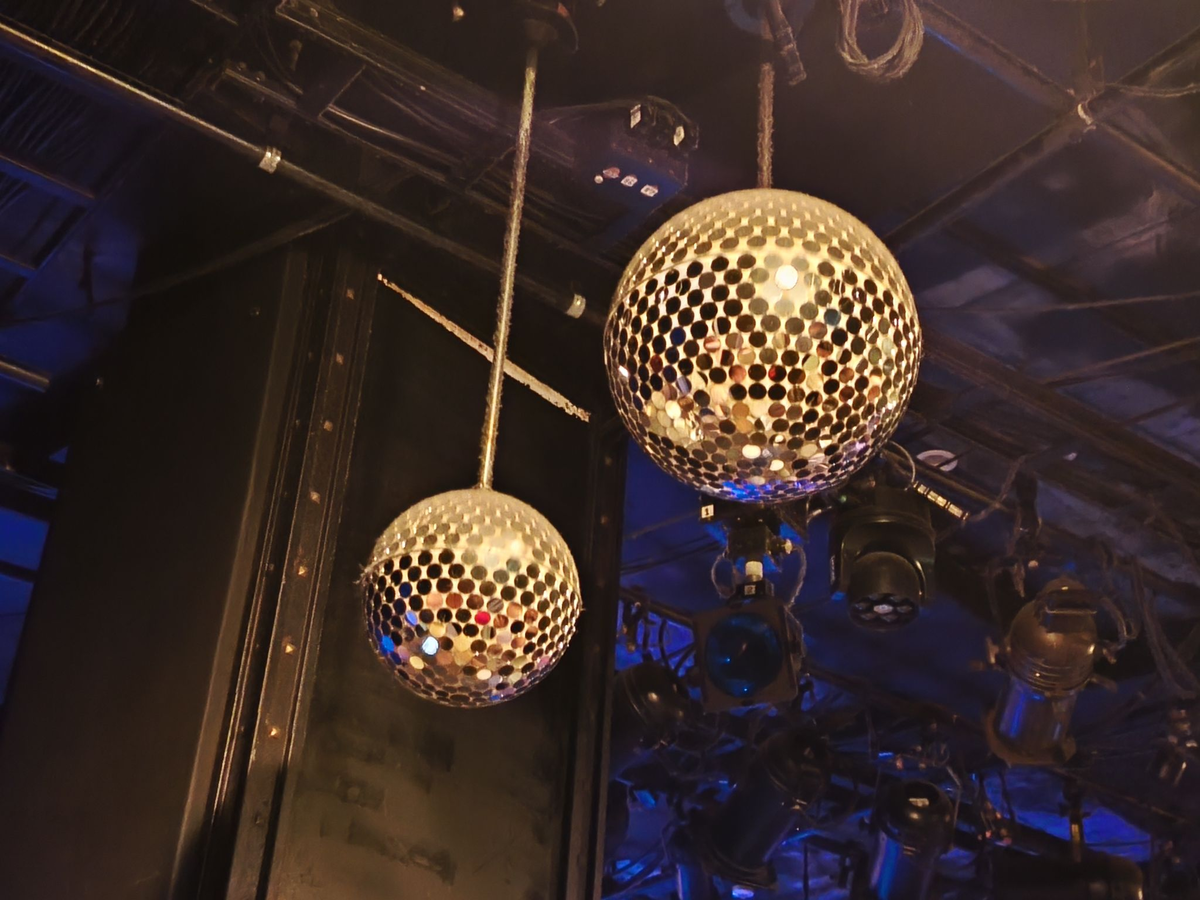
途中ミラーボールが回って、懐かしいディスコを感じました。

このミラーボール。

全部で9曲、MCありで40分ぐらいで、18時40分頃終了。

iVy のパフォーマンスは、Xに流れているので、探してください。

予想の20-30分ではなく、35分

DYGL

19時10分頃から45分で8曲。

新曲、、Falling Leavesからのニューアルバムの既存曲3曲

予習でDYGLの曲を聴いて、とても懐かしく思いました。

DYGLの曲、あのデカいスピーカからの音じゃなんだかと思いましたが、小さなスピーカーを置いて、デカいスピーカー使わなかったのが、バンドのライブ感満載で最高だった

こちらも、予想の20-30分ではなく、40分

Homecomings

流石にここまでで20時ぐらいなので、ドリンク券を発動。スペースが空いている、例の柱の後ろに移動。ここからでは、左半分は見えないのですが、今回は右側にボーカルの畳野さんが来たので、丁度いい感じになりました。

開始は20時10分ぐらいで、21時38分までアンコール含めて10曲ぐらい。1時間20分

ずーと、ガールズバンドだと思っていて、予習で韓国公演の動画であれなんかと思っていたのですが、 昨日のライブで確認できました。 ごめんなさい。

事前予習かなり違って、1曲目から、あれ、なんか最近の羊文学?と思いました。

元々、羊文学 => リーガルリリー からの、Homecomings だったので、まー、それは理解できるのですが、

全然違ったんですよ。

Youtube Music で曲聞くより、今回のライブの方がめっちゃよかったです。

この動画みたいだったけど、もっとパワフルだった。

www.youtube.com

演奏後の写真撮影

物販

帰りも物販やっていて、iVy のお二人は、売っていました。。

公演後のそれぞれの公式Xから

iVy

DYGL

Homecomings

おわりに

当日券あった。chilldspot の時も当日券あった。ということは、。。。

40分、35分、1時間20分でざっくり2時間半、6000円はお安かった。手数料高いけど。

17時30分頃、今日のポジションを決めたときに、メールが入りました。

なんと、次のライブが当たったお知らせでした。。。嬉しい。

で、次のライブは、当たった、そのライブです。。。

RapidusのRaadsで一番重要なのは、AIではなく「2nmの物理情報」なのでは?

はじめに

RISC-V Day Tokyo 2026 Springで、下記のXの投稿のRapidusの鶴崎宏亀氏が紹介した「Raads(Rapidus AI-Agentic Design Solution)」のスライドを見ていました。

以前からRapidusがAIを使った半導体設計環境を開発していることは知っていましたが、今回のスライドをじっくり見ると、私が最も気になったのは「LLMでRTLを生成する」という部分ではありませんでした。

むしろ重要なのは、その後ろにあるRapidus 2nmの物理設計情報と、実際の製造データをAIによる設計探索につなげようとしていることです。

Rapidus自身もRaadsを、AI/機械学習を使って製造データを設計最適化に活用するツール群として位置付け、DMCO(Design-Manufacturing Co-Optimization)によって設計と製造を同時に最適化する方向を示しています。(Rapidus)

Raadsで重要なのは「AI」より、そのAIが評価できる環境

今回のスライドで非常に気になったのが、Raads.Predictorです。

入力されるのはRTLとSDC。そしてRapidus 2nm向けのPDK、Standard Cell、SRAMなどを使って、

Synthesis → Floorplan → Place → CTS → Global Route → PPA

まで実行する。

しかも、一つの設計を評価するだけではなく、

Can try many cases in parallel with ML technique

とあります。

つまり、Raads.Predictorは「AIがPPAを予測するだけ」の仕組みではなく、実際のPhysical Synthesisを大量に回して、設計空間を探索するための仕組みと見ることができます。

ここでOpenROADが使われているのも重要です。

OpenROADが単なるオープンソースEDAというだけではなく、AIが生成・変更した設計を実際の物理設計に通して、

「この変更をするとPPAはどうなるのか?」

を評価するための環境になっています。

私が以前から考えていた、

アーキテクチャ探索 → マイクロアーキテクチャ探索 → RTL生成 → Physical Design → PPA評価 → 次の候補を探索

というループにかなり近いものです。

では、Rapidusだからできることは何なのか?

ここが今回、一番重要だと思ったところです。

AIによるRTL生成だけなら、Rapidusでなくてもできます。

OpenROADを使ったPPA探索も、Rapidusでなくてもできます。

しかし、

Rapidus 2nmの物理情報 + Rapiduѕの製造データ

となると話が変わってきます。

RISC-V Day Tokyo 2026 Springの講演概要を見ると、Rapidusでは2nm向けに数百種類以上のStandard Cellを整備し、電気特性モデル、HDL、LEF/DEF、GDS-IIなど、EDAで必要となる各種ビューを用意しています。また、社内評価・検証用として自社開発のStandard Cell Libraryも整備しているとされています。(RISC-V 協会 | RISC-V Association)

これはAIにとって非常に重要です。

AIが設計を変更しても、

「Rapidus 2nmでは、この変更が実際にどういう面積、電力、遅延になるのか」

を評価できなければ、設計探索には使えません。

つまり、AIが賢いことよりも、そのAIが物理世界を評価できることの方が重要なのではないでしょうか。

「Shift-Left」の意味

3枚目のスライドでは、従来の設計方法とRapidusの方法が比較されています。

従来は、

Logic Design → Netlist → Physical Design → PnR → Feedback → Logic Design

というループを繰り返します。

つまり、RTLをかなり作り込んでから物理設計をして、

「ここ、2nmでは駄目だった」

ということが分かる。

Raads.Predictorでは、この物理設計の情報をもっと上流へ持ってきます。

Logic DesignとPhysical Designを並行して改善する。

これがスライドにあるShift-Leftです。

これはAI時代の半導体設計では非常に重要になると思います。

AIにRTLを書かせるだけなら、RTLを生成する能力が向上すればよい。

しかしAIに本当に半導体を設計させるなら、

「生成した設計が物理的にどうなるのか」

を即座に返してやる必要があります。

だから、私はRaadsの核心はGeneratorではなく、むしろPredictorを中心としたフィードバックループにあるのではないかと思いました。

さらに重要なのがDMCO

そして2枚目のスライドを見ると、さらに先があります。

Prompt → Raads.Generator → RTL/SDC → Physical Synthesis → GDS

だけで終わっていません。

GDSの先には、

Rapidus → Chip manufacturing → DMCO → HotSpot Information

があります。

そして、その情報が再びAI側に戻ってきます。

これは単なる「AIによるEDA」ではありません。

設計 → 製造 → 実データ → 次の設計

というループです。

RapidusもDMCOについて、製造工程から得られる大量のプロセスデータを設計初期段階へフィードバックし、設計マージンの削減や性能向上につなげる考え方を示しています。(Rapidus)

ここまで来ると、AIが学習する対象はRTLや過去の設計データだけではありません。

「Rapidus 2nmで実際に製造したら、どこで問題が起きたのか」

という実世界のデータまで、次の設計に利用できる可能性があります。

おわりに

今回のRaadsのスライドを見て、私が一番重要だと思ったのは、

「AIが半導体を設計する」ことではなく、「AIが半導体の物理世界からフィードバックを受けながら設計を探索できる環境を作る」こと

です。

そのためには、

Rapidus 2nmのPDK

Standard Cell / SRAMの物理情報

OpenROADなどによるPhysical Synthesis

PPAの高速評価

MLによる大量の設計空間探索

LLMによるRTL生成

そして最終的には、

Rapidus Fabの実製造データ

が必要になります。

つまり、Raadsの価値を支えるのはAIモデルだけではありません。

「Rapidus 2nmの物理情報と製造データを持っていること」

こそが重要なのではないでしょうか。

AIがRTLを書く時代から、AIが設計空間を探索する時代へ。

そして、その先には、

「製造した結果をAIが学習し、そのAIが次の半導体を設計する」

というループが見えてきます。

そう考えると、今回のRaadsは「AIによる設計支援ツール」というより、Rapidus 2nmそのものをAIによる設計探索のためのデータベースにしていく仕組みなのではないか――というのが、今回の妄想です。

実際にLLMが1 Tokenを生成するとき、Rackの中で何が起きているのだろうか?

はじめに

前回、NVIDIA GB300 NVL72、AMD Helios、AWS Trainium3、Google TPU 8iを「LLM推論を行う1台の巨大なコンピュータ」として比較してみました。そこで重要だと感じたのが、「推論性能はアクセラレータの演算性能だけでは決まらない」ということです。今回はもう少し具体的に、LLMが1 Tokenを生成するとき、Rackの中でどのようなデータが動いているのかを妄想してみます。

DecodeではMemoryからデータを持ってくる

LLMのDecode処理では、入力されたTokenを使って次のTokenを1個ずつ生成します。ここで毎回問題になるのがWeightです。モデルが巨大になるほど、Weightをどこから読み出すのかが重要になります。GPUやAI ASICの演算器がどれだけ高速でも、必要なWeightがMemoryから届かなければ演算器は待たされます。

そこでHBMのbandwidthが重要になります。さらに、何度も使うデータをチップ内部のSRAMなどに置いておけば、HBMまで取りに行く必要がなくなります。この考え方を極端に進めたものがGoogle TPU 8iのようなInference/Reasoning向けの設計なのではないか、と私は考えています。

つまり推論では、「Computeをどれだけ増やしたか」よりも、「Computeに必要なデータをどれだけ近くに置けるか」が重要になる場面があります。

KV Cacheがさらに問題を難しくする

LLM推論ではWeightだけではありません。生成したTokenが増えると、Attentionで利用するKV Cacheも増えていきます。特に長いContextやReasoningでは、KV Cacheがかなり大きなMemory容量を必要とします。

ここで面白いのがMemory階層です。KV CacheをHBMに置くのか、それとも可能な範囲でSRAMなどに置くのか。さらに複数のアクセラレータに分散した場合、必要なKV Cacheをどこから持ってくるのかという問題も出てきます。

つまりLLM推論では、HBM容量だけを比較しても不十分です。「そのMemoryを誰が、どの距離から、どのbandwidthで利用できるのか」まで考える必要があります。

MoEになるとInterconnectが重要になる

さらにMoEモデルを考えると、Rack内のデータ移動が一気に重要になります。入力Tokenを適切なExpertへ送り、Expertの計算結果を再び集める必要があるからです。

ここで登場するのがNVIDIAのNVLink、AMDのUALink、AWSのNeuronLink、GoogleのICIです。

これらは単純な「高速な接続」というより、複数のアクセラレータを1つの巨大な計算資源として利用するための仕組みと考えた方がよさそうです。

例えば72個のGPUや多数のAI ASICがRackに入っていても、アクセラレータ間の通信が遅ければ、MoEのExpert分散によるメリットを十分に引き出せません。逆にInterconnectが高速なら、モデルを複数のアクセラレータに分割しても、あたかも1台の大きなAIコンピュータのように扱えます。

Reductionも重要になる

もう一つ忘れてはいけないのがCollectiveやReductionです。複数のアクセラレータで処理した結果をまとめる場合、単純にデータを送るだけでは終わりません。

どこでReductionするのか。アクセラレータ自身が行うのか、Switch側で処理するのか。それによって必要なbandwidthも変わってきます。

ここを見ると、NVIDIAのNVSwitch、AWSのNeuronSwitch、GoogleのICIなど、単なる「通信路」としてではなく、AI処理全体の一部としてNetworkを設計するという考え方が見えてきます。

おわりに

こうしてLLMの1 Token生成を眺めてみると、AI Rackの中では、Compute、HBM、SRAM、KV Cache、Interconnect、Switchがすべてつながっていることが分かります。

そしてNVIDIA、AMD、AWS、Googleを比較するときも、「GPUとASICのどちらが速い」という話だけでは足りません。

Weightをどこに置くのか。KV Cacheをどこに置くのか。MoEのTokenをどう移動させるのか。Reductionをどこで行うのか。

この4つをRack全体でどう処理するかが、LLM推論システムの設計そのものになっているように思います。

個人的には、これからのAI半導体を見るときには、チップのBlock Diagramだけではなく、「1 Tokenが生成されるまでに、Rackの中をどんなデータが、どの経路で移動しているのか」を見ることが重要になってくるのではないかと思っています。

そう考えると、AI Rackとは、単にAIアクセラレータを大量に並べたものではなく、巨大なMemoryとNetworkを持った「LLM専用コンピュータ」なのかもしれません。

AI Rackを1個の巨大な推論マシンとして見ると面白そうね

はじめに

最近、NVIDIAのGB300 NVL72、AMDのHelios、AWSのTrainium3、GoogleのTPU 8iについて調べていると、単純に「どのAIアクセラレータが速いのか?」という比較では、どうも本質が見えてこない気がしてきました。特にLLMの推論を考えると、重要なのはアクセラレータ単体の演算性能だけではなく、HBM、SRAM、アクセラレータ間のInterconnect、そしてRack全体をどう使うかです。そこで今回は、この4社のAI Rackを「LLM推論を行う1台の巨大なコンピュータ」として眺めてみます。

LLM推論では「計算する」より「データを動かす」ことが重要になる

LLM推論には大きくPrefillとDecodeがあります。Prefillでは大量のTokenをまとめて処理するので演算性能も重要ですが、Decodeでは1 Tokenずつ生成していくため、WeightやKV CacheをMemoryから読み出す処理が非常に重要になります。つまり、GPUやASICの演算器を増やすだけでは、推論性能は簡単には上がりません。

ここで重要になるのがMemoryです。HBMの容量とbandwidth、さらにチップ内部のSRAMをどう使うのか。そしてモデルを複数のアクセラレータに分散した場合、その間でどれだけ高速にデータを交換できるのか。この部分がRack-scale なAIシステムでは非常に重要になっています。

NVIDIA、AMD、AWS、Googleで何が違うのか

  • NVIDIA GB300 NVL72
  • AMD HELIOS (MI455X)
  • AWS Trainium 3
  • Google TPU 8i

NVIDIAのGB300 NVL72は、72個のBlackwell Ultra GPUをNVLink/NVSwitchで接続し、Rack全体を非常に大きなGPUコンピュータとして扱う思想です。LLM推論では、単一GPUの性能だけではなく、NVLinkによってGPU間でWeightやActivation、MoEのExpertデータなどを高速に交換できることが重要になります。

AMDのHeliosも、MI455Xを中心にRack-scaleでアクセラレータを接続する方向ですが、ここではUALink/UALoEという別のInterconnectの思想が見えてきます。特にHBM4による大容量・高帯域Memoryと組み合わせることで、「アクセラレータを増やす」だけではなく「MemoryとInterconnectを含めて推論システムを作る」という方向が見えてきます。

AWSのTrainium3は、さらに面白い存在です。Trainium3そのものだけを見るのではなく、NeuronLinkとNeuronSwitchを含めたAWS独自のシステムとして考える必要があります。AWSの場合、ハードウェアだけでなくNeuron Software Stackまで含めて、クラウド上で大量のアクセラレータを使うことを前提にしている点が特徴です。

そしてGoogleのTPU 8iです。今回の4社比較では、私はここが特に面白いと思っています。TPU 8iはInference/Reasoningを強く意識した構成になっており、SRAM容量の増加やCAEによるデータ処理の最適化など、単純な演算性能とは違う方向から推論性能を高めようとしています。特にReasoningモデルではKV Cacheが大きくなるため、Memory階層をどう設計するかは非常に重要になります。

4社の違いはInterconnectに表れる

4社を推論という視点で見ると、面白いのはInterconnectです。

  • NVIDIA : NVLink
  • AMD : UALink
  • AWS : NeuronLink
  • Google : ICI

名前は違いますが、やろうとしていることは似ています。それは、複数のアクセラレータを単なる「複数枚のカード」ではなく、1つの巨大なAIコンピュータとして扱うことです。

LLM推論では、Weight、Activation、KV Cache、MoEのExpertなど、非常に大量のデータが移動します。したがって、これからのAI Rackでは「何TOPS出るか」だけではなく、1 Tokenを生成するためにRack内でどれだけデータを移動しなければならないのかを見る必要があるのではないでしょうか。

おわりに

NVIDIA、AMD、AWS、Googleの4社を推論という観点で眺めてみると、それぞれが違うアプローチで「データ移動」という問題に取り組んでいるように見えます。

NVIDIAはNVLinkを中心にGPUを巨大化し、AMDはUALinkによるOpenなRack-scale architecture、AWSはTrainium+NeuronLink+NeuronSwitchというクラウド専用のシステム、GoogleはTPU 8iでSRAMやCAEまで含めてInference/Reasoningそのものを最適化する。

結局のところ、AI半導体の競争は「一番速いチップ」を作る競争から、「LLM推論に必要なデータを、どこに置き、いつ、どの経路で動かすのか」をRack全体で設計する競争へ変わってきているのかもしれません。ここをもう少し掘っていくと、4社のAI Rack Architectureの違いが、さらに見えてきそうです。

AWS Trainium 3 UltraServer、Rackの中はこうなっているのかな?

はじめに

以前、AWS Trainium 3 Serverについて、AWSの公開資料と実機写真を見ながら、「Trainium 3ではNeuronSwitch v1が登場し、4個のTrainium 3を搭載したCompute TrayをSwitchで接続するようになったのかな?」と妄想しました。

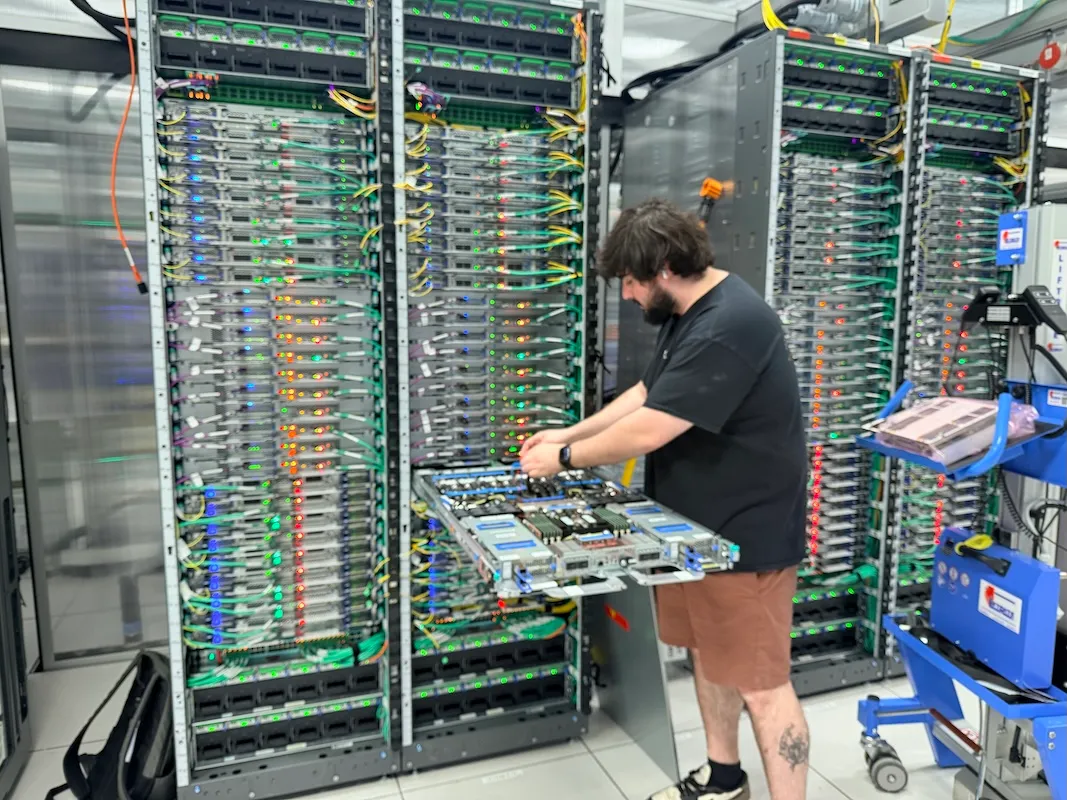
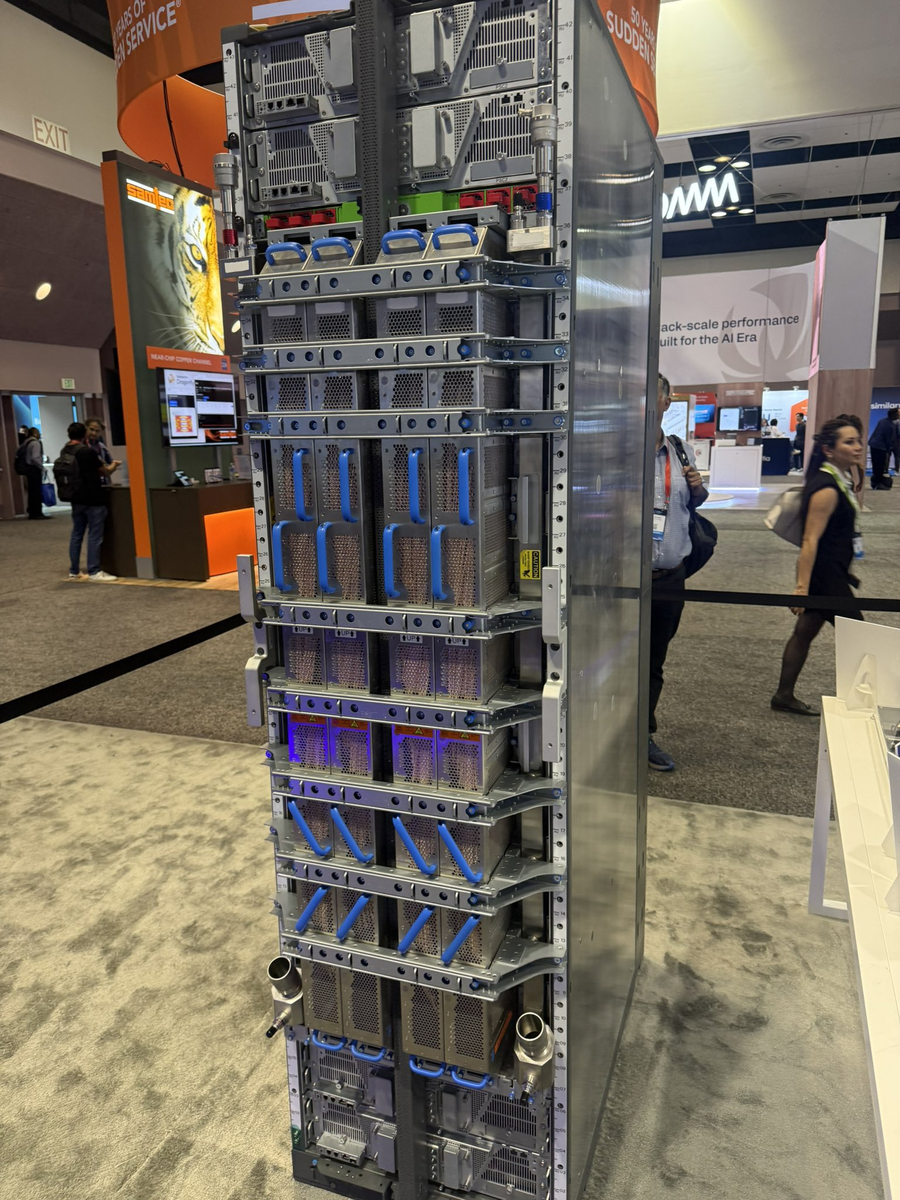
その後、Trainium 3のRack内部がわかる写真がいくつか出てきました。特に、TechCrunchのAmazon Trainium Labの写真を見ると、Rackの構成について、もう少し具体的に妄想できそうです。

1 RackにCompute Trayが18枚、NeuronLink Switch Trayが10枚

まず訂正です。上記のブログ(AWS Trainium 3 Server)では、AWSの資料にあった「36 servers × 4 Trainium 3 = 144 Trainium 3」から、36枚のCompute Trayが1つの構成単位なのかな、と考えていました。

ところが、SemiAnalysisのTrainium 3 Deep Diveを見ると、Trainium 3 NL72x2 Switchedでは、1 RackにCompute Trayが18枚、中央にNeuronLink Switch Trayが10枚という構成になっています。

Compute Tray 1枚にはTrainium 3が4個載っています。したがって、

18 Compute Tray × 4 Trainium 3 = 72 Trainium 3 / Rack

となります。そして、これが2 Rackで、

72 × 2 = 144 Trainium 3

となるわけです。

つまり、Trainium 3 UltraServerの「144」という数字は、1 Rackではなく2 RackのScale-up構成として考えた方がよさそうです。

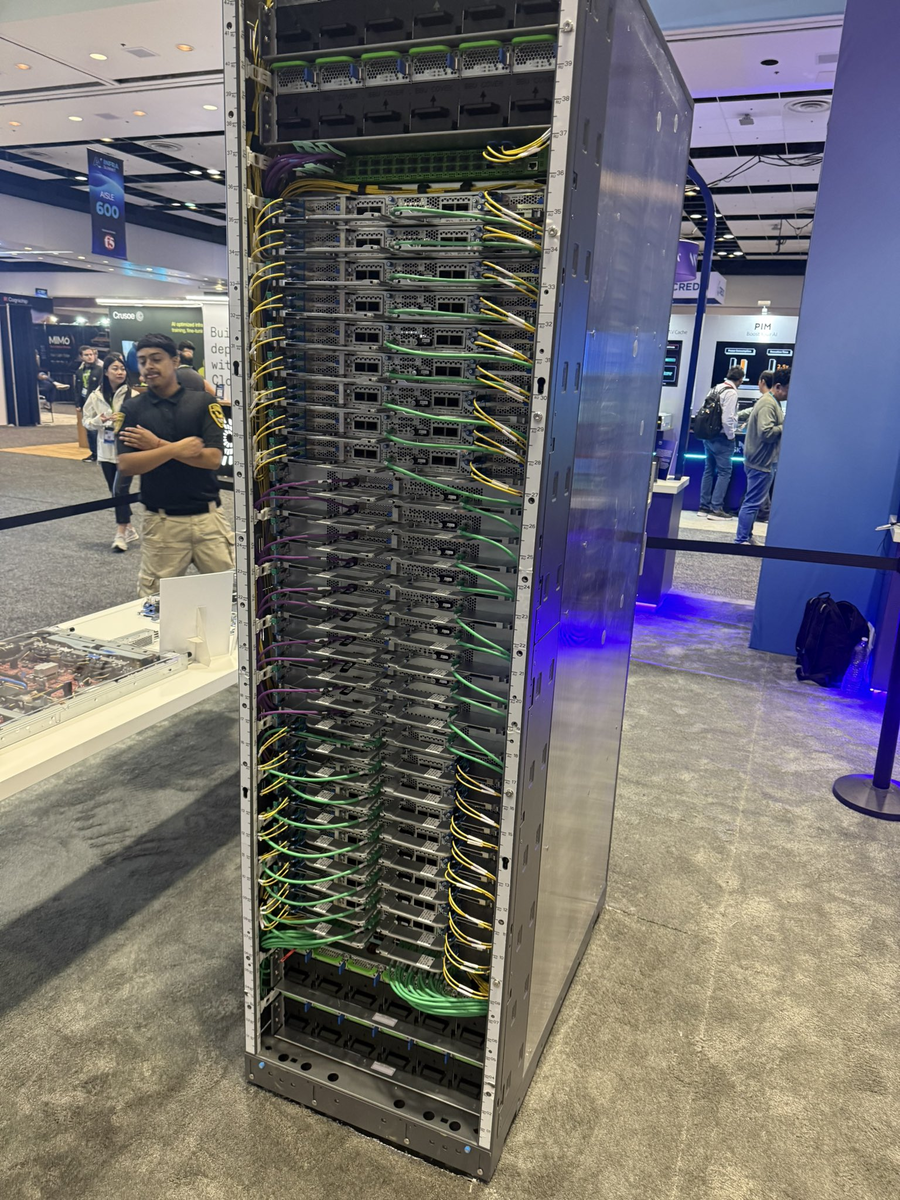
TechCrunchの写真を見ると、Compute TrayがRackの上下に並び、その中央にSwitchらしきTrayがまとまって配置されています。これを見ると、「なるほど、これが10枚のNeuronLink Switch Trayなのか」と思えてきます。システムは、2つのRackから構成されているのも分かります。

下記の写真は、TechcrunchのAn exclusive tour of Amazon’s Trainium lab, the chip that’s won over Anthropic, OpenAI, even Appleに載っているものです。説明のために引用します。

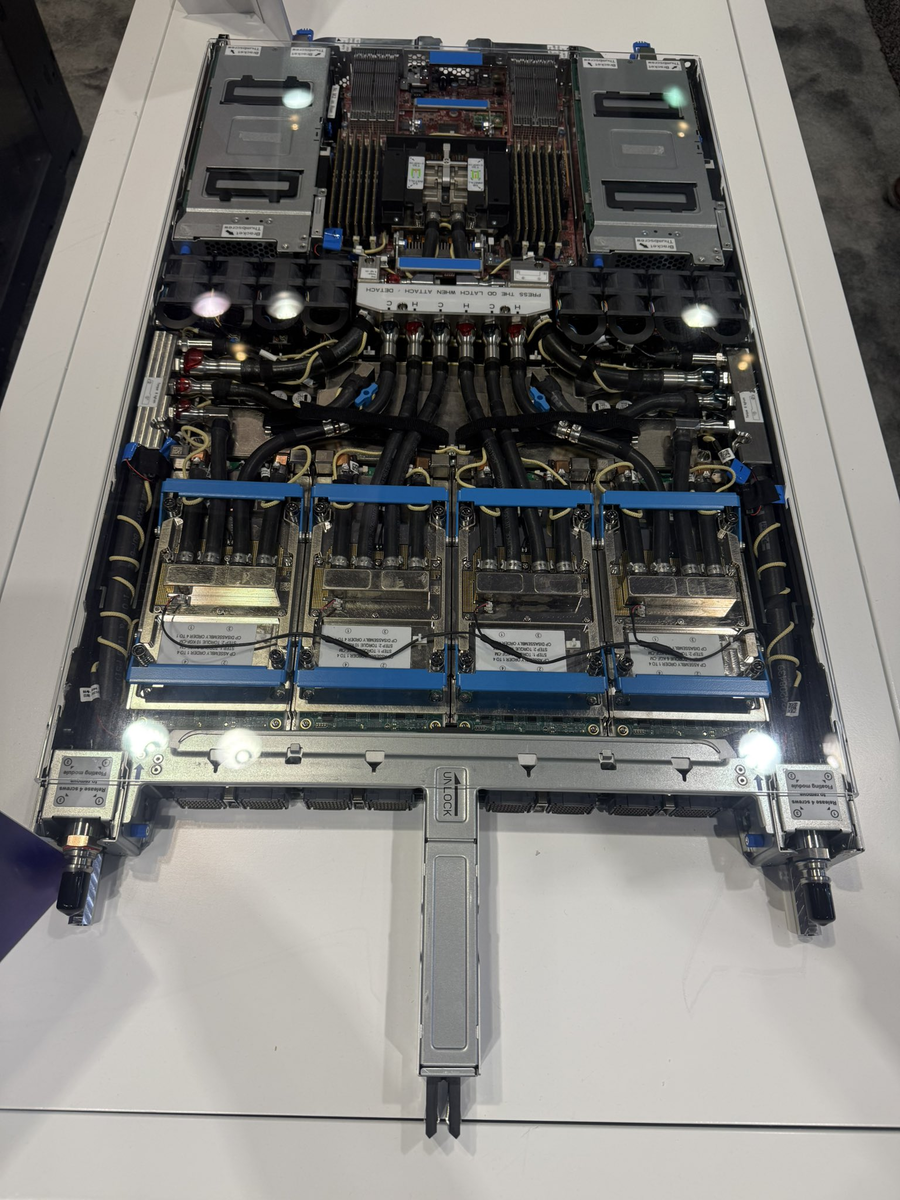
このXの投稿では、もっとクリアなRackの写真が添付されています。説明のために引用します。

RackのRear側も載っています。真ん中にケーブルか何かが入っているんでしょうね。

Trainium 3 Tray の Rear 側のコネクタも見えますね。

Compute Trayの中にもSwitchがある

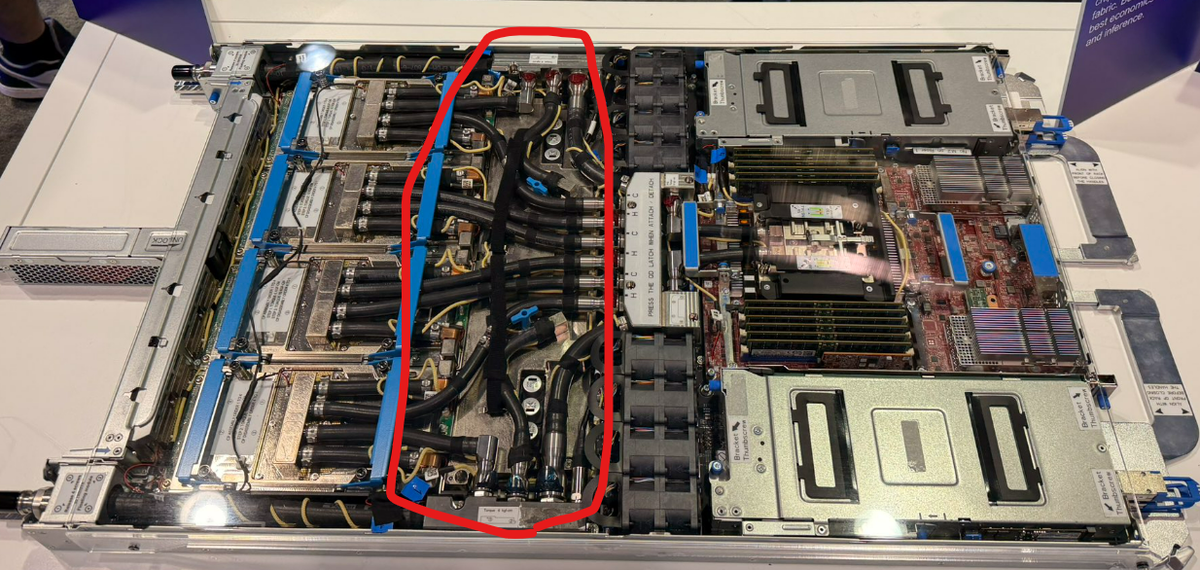
さらに面白いのが、以前の写真で赤丸を付けた部分です。(下記の写真は、このXの投稿に添付されていたものです。説明のために引用します。)

4個のTrainium 3が載ったCompute Trayの中央付近に、たくさんの液冷配管が集まっています。ここには、Trainium 3同士を接続するPCIe 6.0の32-lane Switchが8個搭載されているとSemiAnalysisの記事では説明されています。

つまり、SwitchはRack中央にだけあるのではありません。

Compute Tray内部にも8個のSwitchがある。

そして、

18 Compute Tray × 8 Switch = 144 Switch

となります。

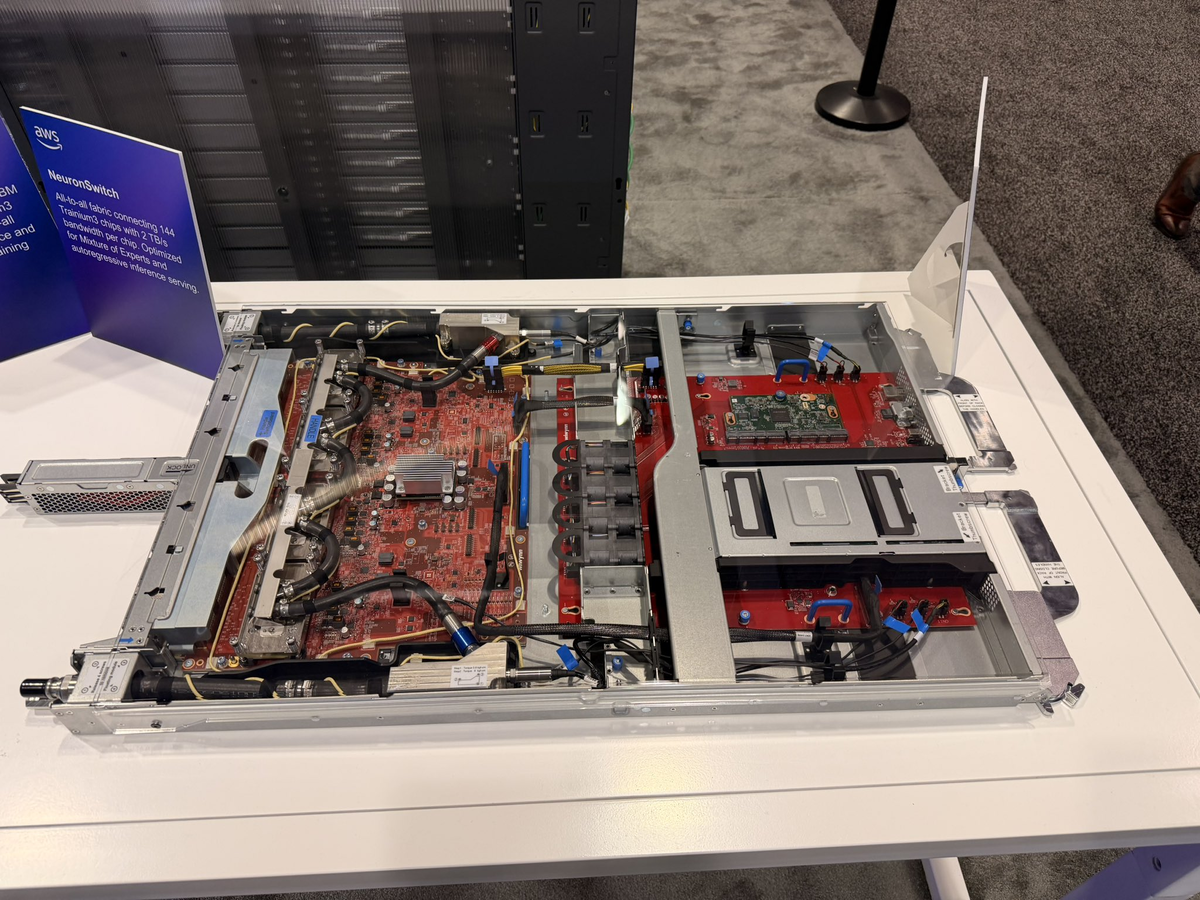
さらにRack中央の10枚のNeuronLink Switch Trayには、160-laneのPCIe Switchが合計40個(1つのNeuronLink Switch Trayには4個)あります。つまり1 Rackだけで、

144個+40個=184個のScale-up Switch

が存在することになります。

これはかなり凄い数です。

NeuronSwitch v1 Tray。(下記の写真は、このXの投稿に添付されていたものです。説明のために引用します。)

Switchまで液冷なのが面白い

そして、今回の写真を見て個人的に一番気になるのが、Compute Tray内部のSwitchにも冷却用の配管が接続されているように見えることです。

SemiAnalysisの資料でも、Trainium 3 NL72x2 Switchedでは、液冷の対象としてTrainium 3だけではなく、NeuronLink v4用の32-lane PCIe 6.0 SwitchとGraviton 4 CPUが挙げられています。

つまりAWSは、単に「Trainium 3を液冷している」のではなく、Trainium 3を大量に接続するScale-up NetworkのSwitchまで冷やしているわけです。

これは、AIアクセラレータの性能競争が、もはやチップ単体の性能だけではなく、チップ間通信と、その通信を支えるSwitch Fabricの電力・冷却まで含めたシステム設計の競争になっていることを感じさせます。

おわりに

今回、写真と公開情報を合わせて考えると、Trainium 3 NL72x2 Switchedは、

1 Rack:Compute Tray 18枚+NeuronLink Switch Tray 10枚=Trainium 3 72個

そして、

2 Rack:Trainium 3 144個

という構成になっているようです。

さらにCompute Trayの中には8個の小型Switch、Rack中央には40個の大型Switchがある。

以前の記事では「Trainium 3ではSwitchが必要になった」というところまででしたが、今回の写真を見ると、そのSwitchがRackの中に大量に存在し、しかも一部は液冷されていることが見えてきました。

NVIDIAのNVLink Switchとはまた違った、AWS独自のScale-upの作り方が見えてきた感じです。

関連ブログ

vengineer.hatenablog.com

映画 : 悪魔のシスターのBDをゲットした

はじめに

映画 : 悪魔のシスターを観たのは、

2008年9月

vengineer.hatenablog.com

vengineer.hatenablog.com

今回、18年振りに観ました。。

振り返り

過去のブログによると、

主役のマーゴット・キダーは、スーパーマンシリーズ(1979~)のロイス・レイン役でメジャーになりましたね!
メジャーになる前ですので、きわどいシーンも出てきます。リーインカーネーション(1979)にも出ています。
マーゴット・キダーは、3回も結婚しているのですね。何とも、、、
それからマーゴット・キダーの元夫役のウィリアム・フィンレイは、あのファントム・オブ・パラダイス(1974)の青年音楽家ウィンスローであり、ファントムです。
デュアルフレーム(2分割画面)をうまく使っているところは、殺しのドレスにつながっている
またのぞきのシーンは、ボディ・ダブルへ、夢のシーンは殺しのドレスのラストへ!
私立探偵は、いつまで監視しているのだろうか? ラストの「THE END」が妙に新鮮に感じたのはなぜだろう!

とある。

今回、気が付いたことは、音楽がヒッチコックの作品を担当した

である。

でも音楽を担当している。

ちょっと気になったところ

映画、悪魔のシスターの1時間21分以降の音楽が映画、殺しのドレスのラストの病院のシーンと非常に似ていたが、どう

と、Gemini -san に聞いてみた

1時間21分以降(クライマックスのクリニック〜催眠・悪夢シークエンス)の音楽と、『殺しのドレス』ラスト(精神病院〜悪夢のラストシーン)の音楽が非常に似ていると感じられたのは、まさに正解です。

この類似には、監督ブライアン・デ・パルマの映画作りにおける明確な背景と音楽的な仕掛けが存在します。


1. 監督と作曲家の共通点

両作ともブライアン・デ・パルマ監督作品であり、アルフレッド・ヒッチコック監督の『サイコ』などを強い下敷きにしたサイコスリラーです。

  • 『悪魔のシスター』 (1973年)
  • 作曲: バーナード・ハーマン(ヒッチコック作品『サイコ』『めまい』等の巨匠)
  • 該当シーンの曲名: The Solution / The Clinic / Hypnotic Trance や Separation Nightmare

  • 『殺しのドレス』 (1980年)

  • 作曲: ピノ・ドナッジョ
  • 該当シーンの曲名: The Asylum / The Nightmare

バーナード・ハーマンは1975年に亡くなったため、デ・パルマ監督は『キャリー』以降、ピノ・ドナッジョを自身のメインコンポーザーに迎えました。


2. なぜここまで似ているのか?

① ハーマン様式への直接的なオマージュ

ピノ・ドナッジョは『殺しのドレス』を作曲する際、かつてデ・パルマがバーナード・ハーマンと作り上げた音楽世界を意識的に踏襲・再構築しました。 不穏で悲痛な不協和音の弦楽器セクション、繰り返し旋律(オスティナート)、そして突如として不安感を煽る木管・金管の配置は、ハーマンが『悪魔のシスター』のクライマックスで確立した手法そのものです。

② 映画的シチュエーションの完全な重複

両作のラスト15〜20分は構造が驚くほど一致しています。

構造 『悪魔のシスター』 (1時間21分〜) 『殺しのドレス』 (ラストシーン)
舞台 精神クリニック / 病院 精神病院 (Asylum)
展開 精神催眠・トラウマの回想〜偽りの平穏 精神病院での解説〜主人公の見る悪夢
演出 夢と現実の境界が崩れるショック描写 忍び寄る殺人鬼の悪夢(ジャンプスケア)

デ・パルマ監督は「精神病院・催眠・悪夢」という同一のセルフオマージュ構造を採用しているため、音楽的にも「一見静けさを保ちながら、徐々に狂気と不安を増幅させて一気に破裂させる」という全く同じアプローチが取られています。


耳で感じられた違和感や既視感は、「ハーマンが作ったオリジナル」と「それを敬愛してドナッジョが再構築したスコア」という、デ・パルマ映画の音楽的継承の歴史そのものを捉えた正確な観察です。

見ていないデパルマ作品

残りは、御婚礼/ザ・ウェディング・パーティー<未>(1969)と悪夢のファミリー<未>(1979)
どちらも未公開でDVD無し。特に、悪夢のファミリーは、ナンシー・アレンが出ているので是非みたい。。。。
昔、レンタルビデオがあったようだが、

とあったが、

は、レンタル落ちのVHSをゲットして、見た。。

また、Youtube にも何故かあった。

www.youtube.com

残るは、

だが、これも、Youtube にある。

www.youtube.com

調べたら、全部、Youtube にあった

おわりに

特典にあった、ビデオを観ていたら、

は、ドキュメンタリーっぽい。

あ、Brian De Palma Archives というのがあるじゃん

www.youtube.com

他にもなんか、ある。。

おう、嬉しい。

あれ、Sister もあった